Données d’entraînement robotique : le nouvel actif stratégique
Les données d'entraînement robotique deviennent un actif clé. Analyse de la valorisation de Mecka AI et des enjeux pour l'IA industrielle.
Écrit par
Rédaction
Publié le
12 septembre 2026
La ruée vers l’or silencieuse des datasets physiques
Le capital-risque ne finance plus seulement des machines, il achète la matière première qui leur permet de penser. Mecka AI illustre cette bascule brutale. Cette startup de deux ans approche une valorisation de 500 millions de dollars dans un tour mené par Sequoia TechCrunch. L’accélération est fulgurante : la levée intervient quelques mois à peine après sa Série A TechCrunch. Pour les décideurs industriels, le message est clair. La donnée physique captée par les capteurs et actionneurs a dépassé l’utilité technique pour devenir un instrument de pouvoir économique.
Contrairement aux corpus textuels du web, les datasets robotiques sont rares et coûteux. Ils capturent la réalité avec ses frictions et ses contraintes mécaniques. Les modèles d’action ne peuvent pas s’appuyer sur internet ; ils doivent apprendre auprès de machines réelles ou d’humains. C’est pourquoi le marché observe une course effrénée pour acquérir ces informations précieuses TechCrunch. En France, des acteurs comme le CEA Tech structurent leurs bases tactiles et cinétiques. L’enjeu est double : retenir ces actifs et créer des standards européens.
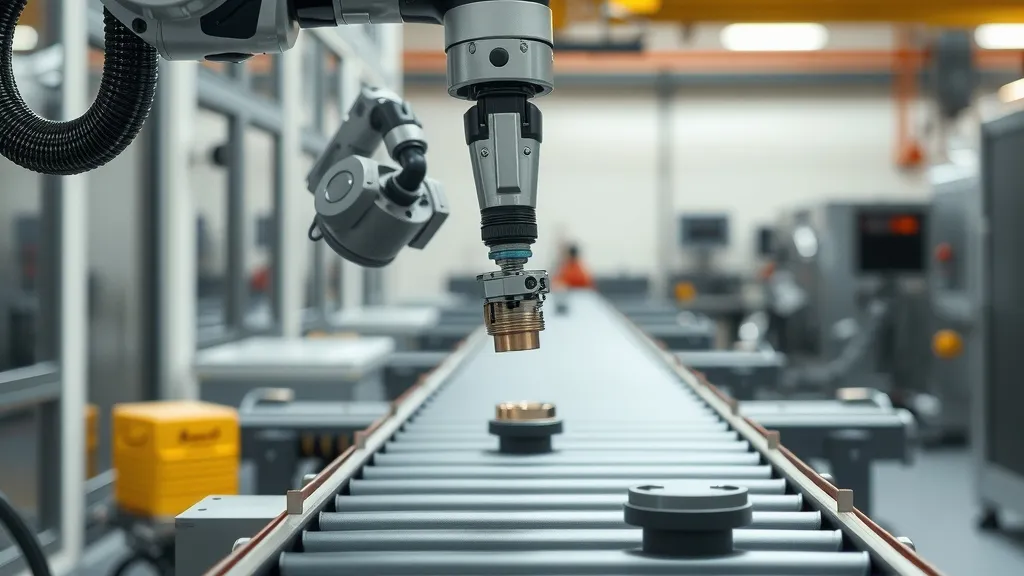
La décision immédiate pour toute usine automatisée est de cartographier ses flux de données. Beaucoup ignorent qu’ils produisent des pépites exploitables. Une ligne d’assemblage génère des milliers de points par seconde sur les forces exercées et les erreurs de manipulation. Ces traces constituent la base d’un avantage concurrentiel futur. Il faut sécuriser le stockage avant que ces flux ne soient absorbés par des tiers sans compensation. La traçabilité devient cruciale, comme le montre l’émergence de solutions hybrides où la Blockchain et robotique autonome : la révolution de la preuve d’action en 2026 offre un cadre vérifiable pour certifier l’origine des données collectées sur le terrain.
Souveraineté des données contre dépendance API
Externaliser la collecte vers des plateformes cloud centralisées crée une vulnérabilité majeure. En confiant vos données d’entraînement à des intermédiaires, vous acceptez implicitement que votre savoir-faire opérationnel soit agrégé et potentiellement revendu à vos concurrents. La souveraineté ne se limite plus à la conformité RGPD ; elle touche au cœur de la propriété intellectuelle industrielle. Si votre algorithme de préhension est entraîné chez un fournisseur américain, vous perdez le contrôle sur l’usage de ces données pour améliorer les modèles globaux.
Le risque d’exfiltration cognitive est réel. Dans le domaine des grands modèles de langage, certaines entités cherchent déjà à extraire les capacités cognitives des systèmes propriétaires via des appels API massifs. En robotique, la logique est similaire mais plus complexe car elle implique des données multimodales (visuel, tactile, proprioception). Protéger son actif data exige une architecture distribuée. Le traitement doit rester local autant que possible. Seuls les gradients ou les paramètres mis à jour doivent être transmis vers le cloud. Cela impose une refonte des infrastructures IT industrielles.
L’adoption de l’edge computing apparaît ici non pas comme une optimisation de performance, mais comme une barrière de sécurité fondamentale. En traitant les données directement sur le site de production, on réduit la surface d’attaque et on empêche la fuite massive d’informations brutes. Les architectures modernes intègrent des passerelles intelligentes qui filtrent et anonymisent les flux avant toute transmission externe. Pour approfondir cette dimension technique, il est utile de consulter les analyses sur l’Edge Computing Révolutionne la Maintenance Prédictive Robotique : Latence Zéro et Fiabilité Maximale, qui illustrent comment le calcul local transforme la gestion des actifs tout en gardant les données sensibles sous contrôle.
Une procédure concrète peut être mise en œuvre rapidement par les DSI et directeurs d’innovation :
- Auditer tous les flux de données sortants des robots et cobots.
- Identifier les données considérées comme “propriété critique” (méthodes uniques, ajustements spécifiques).
- Déployer des nœuds edge locaux pour le pré-traitement et l’anonymisation.
- Négocier des clauses contractuelles strictes interdisant l’utilisation des données clients pour l’entraînement de modèles génériques partagés.
Cette démarche proactive évite la situation où une entreprise découvre trop tard que son expertise terrain a été diluée dans un modèle global inaccessible. La valeur ajoutée revient à celui qui maîtrise la boucle de feedback entre le terrain et le modèle, pas à celui qui possède uniquement l’infrastructure cloud.
Le coût caché de la généralisation en robotique
Investir massivement dans la collecte pose une question redoutable : à quel moment la généralisation devient-elle contre-productive ? Les startups promettent des datasets vastes et variés. Mais en robotique, la précision locale prime souvent sur l’étendue globale. Un modèle entraîné sur des données générales de manipulation d’objets divers sera moins performant qu’un modèle spécialisé sur des composants électroniques fragiles, même si ce dernier utilise moins de données. Le risque est de payer cher pour une moyenne statistique qui ne résout pas les cas extrêmes rencontrés sur les lignes de production réelles.
La généralisation cache également des coûts de sécurité insoupçonnés. Plus un dataset est large et partagé, plus il est exposé aux attaques adversariales. En robotique, une erreur de classification due à une perturbation minime des données d’entrée peut avoir des conséquences physiques désastreuses. Sécuriser ces flux n’est pas optionnel. Les cyberattaques visant la chaîne d’approvisionnement logicielle des robots augmentent, profitant de la complexité croissante des stacks technologiques. Il est impératif de durcir les interfaces entre les couches de perception et les couches de contrôle.
Les implications européennes sont fortes. L’industrie française dispose d’une richesse de données sectorielles unique grâce à son tissu de PME innovantes et de grands groupes aéronautiques ou automobiles. Cependant, cette richesse est fragmentée. Sans mutualisation sécurisée, chaque acteur paie seul le coût de la collecte et de la protection. Des initiatives publiques pourraient émerger pour créer des “data spaces” sectoriels, où les données sont échangées sous forme de modèles fédérés plutôt que de fichiers bruts. Cela permettrait de bénéficier de la puissance collective sans renoncer à la souveraineté individuelle.
Face à cette réalité, la stratégie gagnante n’est pas la chasse aux volumes, mais la qualité contextuelle. Il vaut mieux disposer d’un million de données parfaitement annotées et sécurisées localement que de dix milliards de données bruitées hébergées dans le cloud public. La vigilance doit porter sur les contrats de licence des datasets acquis. Vérifiez systématiquement les droits d’usage commercial exclusif et les restrictions géographiques.
Enfin, la protection active des infrastructures robotiques contre les intrusions reste le maillon faible. Une faille dans le système de collecte peut corrompre tout l’actif data accumulé pendant des années. Les audits de sécurité réguliers sont indispensables. Pour comprendre les enjeux techniques de cette protection, nous recommandons la lecture de notre dossier dédié à l’Edge Computing : La Stratégie Incontournable pour Sécuriser la Robotique Industrielle contre les Cyberattaques 2026, qui détaille les protocoles de chiffrement et les architectures résilientes adaptées aux environnements hostiles.
Questions fréquentes
Pourquoi les données robotiques valent-elles si cher ?
Contrairement aux données textuelles, elles capturent la physique du monde réel. Cette rareté crée une barrière à l'entrée massive pour les nouveaux acteurs.
Quel est l'impact sur les PME industrielles françaises ?
Elles doivent privilégier la souveraineté de leurs propres flux de données. Louer des modèles génériques expose leur avantage concurrentiel opérationnel.